Как собрать семантическое ядро сайта: пошаговая инструкция и проверка
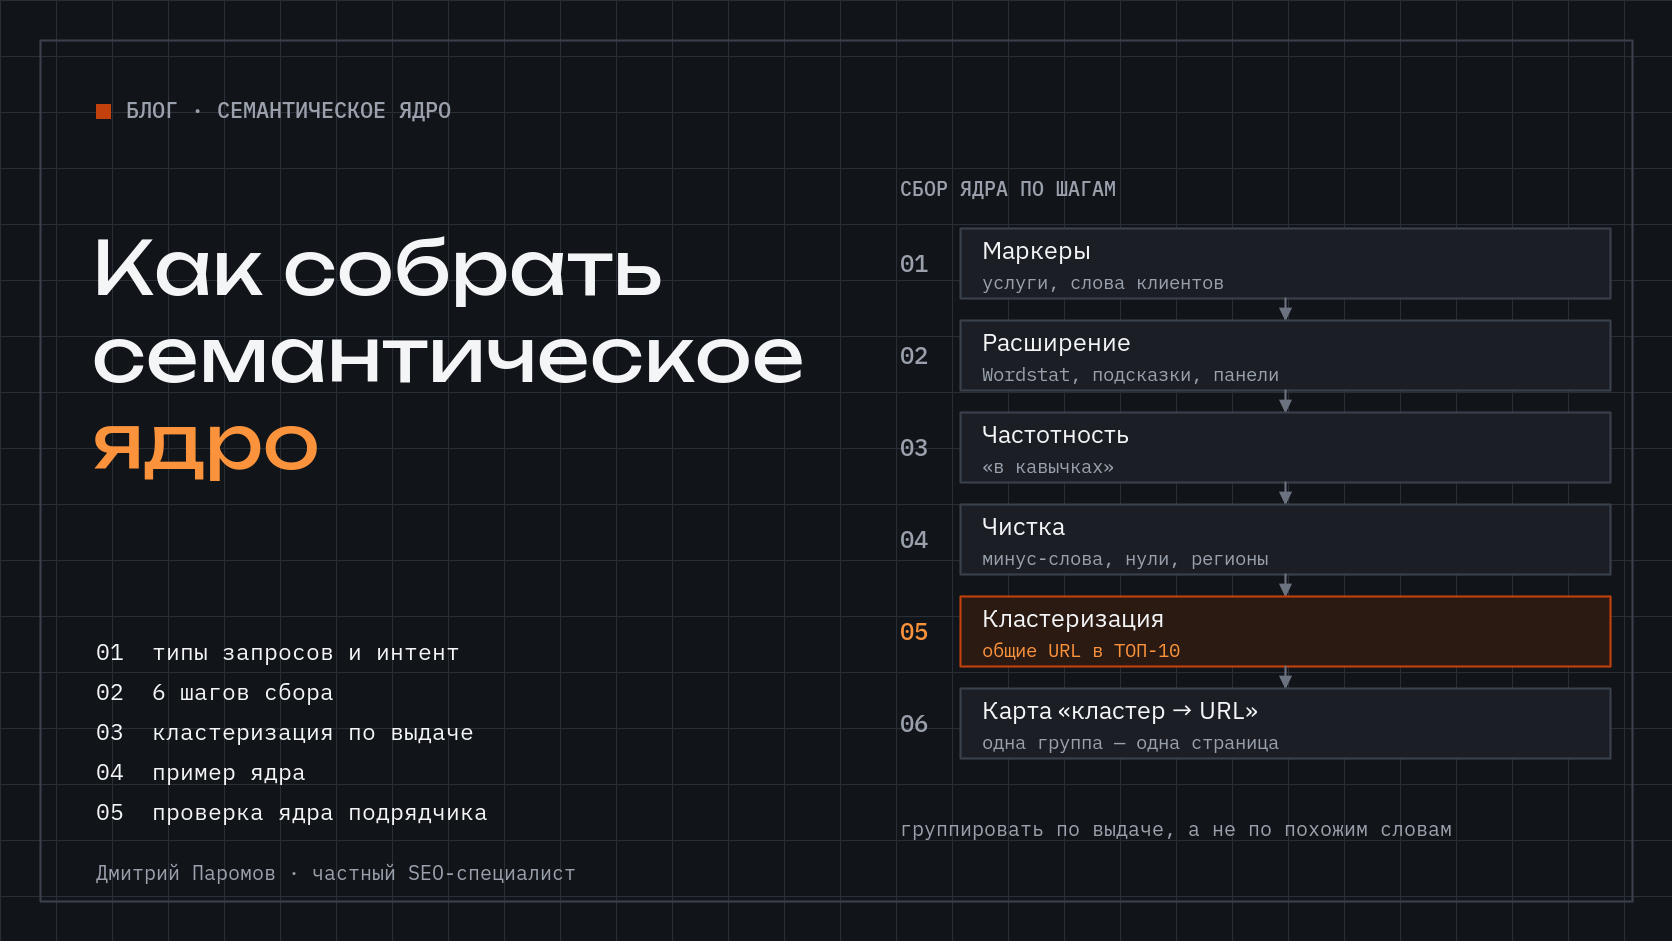
Как собрать семантическое ядро: выписать маркеры, расширить их через Wordstat и подсказки, снять частотность, вычистить мусор, разложить фразы на группы по выдаче и закрепить за каждой группой страницу. Готовое семантическое ядро отвечает на вопрос, какая фраза на какой URL должна вести.
Если ядро вам уже сдал подрядчик, начните с раздела «Как проверить ядро, которое собрал подрядчик»: там чек-лист приёмки.
Что такое семантическое ядро простыми словами
Семантическое ядро — это поисковые фразы, которыми ваши потенциальные клиенты ищут то, что даёт сайт, и распределение этих фраз по страницам сайта.
Из ядра следуют почти все решения по сайту. Какие разделы и страницы нужны. О чём писать тексты на этих страницах. Какие статьи ставить в контент-план. Что продвигать первым, а что может подождать.
Без ядра страницы делаются наугад.
Длинный список слов ядром ещё не является. Ценность появляется, когда фразы сгруппированы по смыслу и у каждой группы есть адрес: эта группа ведёт на страницу услуги, эта на статью, для этой страницу ещё предстоит создать.
Иногда ядро путают с семантикой для рекламы. Для Яндекс Директа собирают в первую очередь коммерческие фразы, под которые пишут объявления, и минус-слова, чтобы реклама не показывалась лишним людям. В SEO-ядро входят и информационные фразы, а главная работа — группировка по выдаче и привязка групп к страницам.
Какие запросы бывают и какая страница на них отвечает
По частотности запросы делят на высокочастотные (ВЧ), среднечастотные (СЧ) и низкочастотные (НЧ). Деление относительное: спрос, который в узкой нише считается высоким, в массовой будет низким, поэтому универсальных границ в цифрах нет.
Второе деление — по интенту. Интент — это цель, с которой человек вводит запрос: узнать что-то, купить или найти конкретный сайт.
| Тип запроса | Пример (условная мастерская по ремонту кофемашин) | Какая страница отвечает |
|---|---|---|
| Информационный | почему кофемашина не греет воду | Статья, инструкция |
| Коммерческий | ремонт кофемашины delonghi | Страница услуги или категории |
| Навигационный | кофемастер казань адрес | Главная, контакты |
| ВЧ | ремонт кофемашин | Главная страница услуги или раздел |
| СЧ | ремонт кофемашин delonghi | Отдельная страница под марку |
| НЧ | delonghi течёт вода снизу | Статья или блок вопросов на странице марки |
Посмотрите на две соседние строки: «ремонт кофемашины delonghi» и «почему кофемашина не греет воду». Первый человек уже готов отдать машину в ремонт, ему нужна страница услуги с ценами, сроками и контактами. Второй пока разбирается, что случилось, и ищет объяснение. Подсказку дают сами поисковики: откройте ТОП-10 по фразе и посмотрите, какие страницы там стоят. Если в выдаче одни статьи, поисковик видит в запросе информационный интент, и страница услуги туда вряд ли пробьётся.
При выборе страницы я смотрю на интент раньше, чем на частотность. Когда коммерческие и информационные фразы свалены на одну страницу, она пытается одновременно продавать и объяснять и рискует проиграть страницам, которые делают что-то одно. Поэтому даже очень частотную информационную фразу я не стану «дописывать» в страницу услуги, а отдам её статье.
Сначала интент, потом частотность.
Сбор семантического ядра по шагам
Весь процесс — шесть шагов, и каждый готовит данные для следующего: маркеры, расширение, частотность, чистка, кластеризация, карта «кластер → URL».
Что понадобится: доступ к Wordstat, таблица или Key Collector для обработки списка, а если сайт уже работает — доступы к Яндекс Вебмастеру, Google Search Console и Яндекс Метрике. Для составления семантического ядра небольшого сайта хватает обычной таблицы. Key Collector нужен, когда фраз становится много.
Если сайта ещё нет, данных Вебмастера и Search Console тоже не будет. Тогда начните с маркеров и Wordstat, а данные сайта подключите после запуска.
Шаг 1. Маркерные запросы и сайты конкурентов
Маркерные запросы — короткие фразы, которыми люди называют ваш товар, услугу или тему: «ремонт кофемашин», «замена жерновов», «чистка от накипи».
Первый источник маркеров — собственный список услуг и товаров. Второй — слова клиентов: как они формулируют проблему в звонках, переписке, заявках. Клиент редко пишет «декальцинация», чаще «кофемашина вся в накипи». Третий — разделы и заголовки сайтов, которые стоят в ТОПе по вашей теме.
У конкурентов смотрите меню, названия категорий и услуг. Это подсказка, какие маркеры вы пропустили. Копировать чужое ядро целиком бессмысленно: у конкурента другие услуги, регион и страницы.
Регион и сезонность учитываются уже здесь. Регион продаж определяет, какую выдачу и какую частотность смотреть: мастерская в Казани не должна строить структуру по спросу всей России. В Wordstat для этого есть вкладка «Регионы» со спросом по регионам и вкладка «Динамика», где видно, как спрос меняется по периодам.
Регион продаж решите до сбора.
Шаг 2. Расширение: Wordstat, подсказки, Key Collector и данные сайта
Основной источник — Wordstat. По каждому маркеру собирают левую колонку: запросы, в которых этот маркер встречается вместе с другими словами.
Поисковые подсказки Яндекса и Google добавляют хвосты, которые люди набирают дословно, особенно длинные вопросы.
Когда маркеров десятки, вручную копировать колонки неудобно. Key Collector собирает фразы пакетно, снимает частотность и помогает чистить большой список. Альтернатива — онлайн-сервисы подбора запросов, например Букварикс: они дают готовые выборки по маркеру.
Я обычно собираю левую колонку Wordstat через API XMLRiver, там же снимаю частотность в кавычках, обрабатываю список в Key Collector и добавляю реальные запросы из Вебмастера, Search Console и Метрики. Фразы с базовой частотой от 100 я расширяю ещё на один уровень, то есть снимаю левую колонку уже по ним. Это моя рабочая настройка: в узкой нише порог стоит опустить.
Данные сайта, который уже работает
В Яндекс Вебмастере есть «Статистика поисковых запросов» и «Управление группами запросов». Там видно, по каким запросам страницы сайта показываются в поиске и какие именно страницы показываются по этим запросам. Учтите ограничение: Вебмастер считает показы и клики только до 50-й позиции, поэтому видна часть данных.
Google Search Console показывает то же самое в отчёте об эффективности, параметр «Запросы». По умолчанию отчёт берёт последние три месяца, период можно поменять.
В Яндекс Метрике откройте Отчеты → Источники → Поисковые запросы: там фразы, по которым люди перешли на сайт. Через сегмент по странице входа можно посмотреть запросы на конкретную страницу, но такой сегмент сам может скрыть часть фраз: Метрика не показывает их, если сегмент раскрывает анонимность посетителей. Редкие фразы, по которым за период пришло меньше 10 посетителей, в отчёт тоже не попадают. Поэтому основным источником запросов сайта остаются Вебмастер и Search Console, а Метрика их дополняет.
Ещё в Вебмастере есть бета-инструмент «Подбор поисковых запросов и анализ рынка»: по ключевому слову он подбирает запросы, можно задать регион и слова-минус.
Можно ли собрать ядро автоматически онлайн
Сервис ускоряет сбор фраз. Чистку, проверку интента и группировку по выдаче он за вас не сделает: эти решения зависят от того, что вы продаёте и где.
Шаг 3. Частотность: базовая, в кавычках и точная
Базовая частотность — то, что Wordstat показывает по фразе без операторов. В неё входят все запросы, содержащие слова фразы, включая длинные хвосты, поэтому она завышает реальный спрос.
Частотность в кавычках учитывает запросы из этой фразы без дополнительных слов. Запись "ремонт кофемашин" посчитает «ремонт кофемашин» и «кофемашин ремонт», но не посчитает «ремонт кофемашин своими руками». На неё и стоит ориентироваться, когда решаете, есть ли у фразы свой спрос. Порядок слов и словоформы кавычки не фиксируют.
Точную частотность получают, добавляя внутри кавычек восклицательный знак перед словами: он закрепляет форму слова. Если важен порядок слов, используют квадратные скобки. Названия «базовая», «в кавычках» и «точная» — принятые в SEO обозначения, в справке Яндекса описаны сами операторы.
| Запись в Wordstat | Что учитывает |
|---|---|
ремонт кофемашин | Все запросы с этими словами, включая хвосты вроде «ремонт кофемашин цены» и «ремонт кофемашин своими руками» |
"ремонт кофемашин" | Только запросы из этих двух слов, в любом порядке и форме |
"!ремонт !кофемашин" | Только эти два слова и только в этих формах |
[ремонт кофемашин] | Фиксированный порядок слов, словоформы учитываются |
Представьте фразу с большой базовой частотностью и скромной частотой в кавычках. Это значит, что почти весь спрос набран чужими хвостами, а саму фразу ищут редко.
Фразы с частотой в кавычках от 5 я обычно отправляю дальше, на снятие ТОП-10 для кластеризации. Порог тоже рабочий: для сайта в узкой нише или маленьком городе его можно опустить.
Шаг 4. Чистка семантического ядра
Чистка семантического ядра начинается с минус-слов. Это слова, которые выдают нецелевой спрос: «бесплатно», «своими руками», «вакансии», чужие бренды, если вы с ними не работаете. Список зависит от бизнеса: для мастерской «своими руками» — мусор, а для магазина запчастей может быть полезной темой для статьи. В Wordstat минус-слова отсекают оператором «-», например ремонт кофемашин -вакансии.
В справке Вебмастера есть наглядный пример: продавец новых пылесосов в рознице исключает «опт», «б/у» и «инструкции».
Дальше убирают мусорные и нулевые фразы: ноль в кавычках, нерелевантные смыслы, чужие регионы.
С сезонностью осторожнее. Фраза, которая сейчас почти не ищется, может быть важна в сезон. Прежде чем удалять, посмотрите её на вкладке «Динамика» в Wordstat.
По регионам оставляйте фразы с теми городами, где бизнес реально работает.
Всё, что удаляете, фиксируйте: отдельным листом или колонкой с причиной. Этот список пригодится при проверке ядра и при его обновлении, когда кто-то спросит, почему такой фразы нет.
Шаг 5. Кластеризация по выдаче
Кластеризация семантического ядра — это группировка фраз, которые поисковик считает одним смыслом и готов закрывать одной страницей.
Группировать «на глаз» ненадёжно. Фразы «ремонт кофемашины на дому» и «ремонт кофемашин с выездом» похожи, но поисковик может показывать по ним разные страницы, а две по-разному сформулированные фразы, наоборот, может считать одной темой. Надёжнее смотреть ТОП-10: если у фраз в выдаче есть общие URL, их можно продвигать одной страницей. Число общих URL, нужное для объединения, называют степенью кластеризации.
При soft-кластеризации выдачу каждой фразы сравнивают с выдачей главной, самой частотной фразы группы. Если общих URL достаточно, фраза попадает в группу. Остальные фразы группы между собой могут быть и не связаны.
При hard-кластеризации одни и те же URL должны быть в выдаче всех фраз группы сразу. Группы получаются уже и точнее. Чем больше общих URL требуется, тем больше групп и тем они мельче.
Я кластеризую по ТОП-10 Яндекса: объединяю фразы, у которых в выдаче есть общие URL. В моём скрипте порог — 3 общих URL, регион выдачи по умолчанию Москва. Если клиент продаёт в другом городе, регион меняю: выдача в Москве и, скажем, в Казани может различаться, а вместе с ней и группы.
Фразы, у которых общих URL ни с кем не нашлось, остаются вне групп. Их стоит просмотреть вручную, а не распихивать по кластерам наугад.
Общие URL в выдаче важнее похожих слов.
Шаг 6. Карта релевантности и структура сайта
Карта релевантности — таблица «кластер → URL». Каждому кластеру назначается одна страница: существующая, если она уже есть на сайте, или новая, которую предстоит создать.
Из карты почти механически получается структура сайта. Коммерческие кластеры становятся разделами, категориями и страницами услуг. Информационные — статьями в контент-плане блога.
Проверьте карту на каннибализацию. Если два кластера назначены на одну страницу или один кластер раскидан по двум страницам, карту стоит пересмотреть: такие страницы будут конкурировать между собой за одни и те же запросы.
Один кластер — одна страница.
Страниц почти всегда не хватает, и всё сразу сделать не получится. Разумно начать с коммерческих кластеров, ближе всего стоящих к заявке, и с тех, под которые страница уже есть и её достаточно доработать. Как выстраивать очерёдность работ на сайте в целом, я разбирал в статье про технический SEO-аудит и приоритеты.
Пример семантического ядра на условной нише
Пример условный: вымышленная мастерская по ремонту кофемашин в Казани. Названия и адреса страниц тоже придуманы.
| Кластер | Фразы | Интент | Страница |
|---|---|---|---|
| Ремонт кофемашин | ремонт кофемашин, ремонт кофемашин в казани, сервис по ремонту кофемашин | Коммерческий | /remont/ (есть) |
| Ремонт DeLonghi | ремонт кофемашины delonghi, сервис delonghi кофемашина | Коммерческий | /remont/delonghi/ (создать) |
| Ремонт Saeco | ремонт кофемашины saeco, починить кофемашину saeco | Коммерческий | /remont/saeco/ (создать) |
| Выезд мастера | ремонт кофемашины на дому, мастер по кофемашинам с выездом | Коммерческий | /remont/vyezd/ (создать) |
| Кофемашина не греет | почему кофемашина не греет воду, кофемашина подаёт холодный кофе | Информационный | /blog/kofemashina-ne-greet/ (написать) |
| Очистка от накипи | как почистить кофемашину от накипи, декальцинация кофемашины | Информационный | /blog/ochistka-ot-nakipi/ (написать) |
| Контакты мастерской | кофемастер казань адрес, кофемастер телефон | Навигационный | /kontakty/ (есть) |
В реальном ядре рядом с каждой фразой стоит частотность в кавычках и дата её съёма, а в примере столбца с частотами нет. Возьмите строку «Ремонт DeLonghi»: фразы про ремонт конкретной марки, интент коммерческий, поэтому группа получает свою страницу услуги, которой пока нет на сайте.
Теперь строка «Кофемашина не греет». Её легко принять за повод для заявки и дописать на страницу ремонта. Но человек ищет объяснение причины, и если в ТОП-10 по этим фразам стоят статьи, поисковик видит здесь информационный интент. Если вставить этот вопрос в страницу услуги, она начнёт отвечать сразу на два разных запроса и будет хуже справляться с основным. Поэтому кластер уходит в статью, а из статьи можно поставить ссылку на страницу ремонта для тех, кто не справится сам.
Сверьте свою таблицу: у каждой строки должны быть интент и страница.
Чем отличается ядро для интернет-магазина
В магазине ядро строят от структуры каталога: категории и подкатегории становятся основными посадочными страницами.
Фильтры и теги превращают в отдельные посадочные только там, где у них есть свой спрос. Условно, если люди ищут «кофемашины с капучинатором» или кофемашины конкретного бренда, под эти фразы имеет смысл сделать страницу фильтра. Если спроса на сочетание нет, отдельная страница не нужна.
Карточки товаров собирают модельные и брендовые запросы, по названию и артикулу. Ядро на каждую карточку вручную обычно не собирают: шаблон заголовков и описаний закрывает эти фразы массово.
Что подготовить ещё до запуска магазина, я расписал в статье SEO для интернет-магазина до запуска.
Можно ли собрать ядро нейросетью
Нейросеть хорошо помогает на старте: придумать маркеры, подобрать синонимы и разговорные формулировки, предложить, на какие группы смыслов делится тема.
Но реальной частотности Wordstat она не знает и вашу выдачу по региону не видит, если вы ей эти данные не передали. Цифры спроса из ответа нейросети нужно перепроверять в Wordstat, а группировку делать по фактическому ТОП-10. Иначе получится правдоподобная таблица, которая не совпадает с тем, что ищут люди и что показывает поисковик.
ИИ — для черновика маркеров. Готовое ядро собирают по данным.
Ошибки при сборе и когда обновлять ядро
Типичные ошибки
- Ориентир на базовую частотность. Спрос выглядит большим, а по фразе в кавычках его почти нет.
- Смешение интентов на одной странице. Страница пытается и продавать, и объяснять.
- Группировка на глаз. Фразы кажутся похожими, а поисковик показывает по ним разные страницы.
- Один кластер на несколько страниц. Страницы конкурируют между собой.
- Удалены сезонные или региональные фразы. Пропадает спрос, который появится в сезон или в нужном городе.
- Гонка за ВЧ. Силы уходят на самые частотные фразы, а заявки приносят более точные.
- Сбор без учёта регионов работы. Частоты и выдача сняты не для того города, где вы продаёте.
Самая дорогая ошибка — первая вместе с шестой. Владелец видит большую базовую частотность, решает продвигаться по общей фразе и вкладывает в неё бюджет, хотя в кавычках у неё скромный спрос, а заявки приходят по фразам с маркой или услугой.
Вторая частая связка: фразы сгруппировали по похожим словам, не глядя в выдачу. Тогда на одной странице оказываются коммерческие и информационные запросы, а соседняя страница забирает часть тех же фраз. Обе продвигаются хуже.
Когда обновлять ядро
Ядро обновляют по поводу. Появились новые услуги или товары. Бизнес вышел в новый регион или сменил его. Спрос сместился: в Wordstat видно, что люди стали искать иначе. В Вебмастере и Search Console появились новые запросы, по которым сайт уже показывается, но для них нет подходящей страницы.
Пересобирать с нуля обычно не нужно. Новые фразы проводят через те же шаги: частотность, чистку, кластеризацию, затем добавляют в существующую карту релевантности. Старую карту сохраняют, чтобы не перепутать, какая страница за что отвечает.
Ядро дополняют, карту сохраняют.
Как проверить ядро, которое собрал подрядчик
Анализ семантического ядра сайта при приёмке не требует SEO-подготовки. Достаточно открыть таблицу и пройти по шести проверяемым признакам.
Чек-лист приёмки ядра
- Указаны частоты в кавычках и дата их съёма.
- Указан регион, для которого снимали частоты и выдачу.
- У каждого кластера есть URL и интент.
- Нет каннибализации: один кластер — одна страница.
- Видно, что выкинуто и почему.
- Если сайт уже работает, в ядре есть фразы из Вебмастера и Search Console.
Частоты в кавычках нужны потому, что базовая частотность завышает спрос и по ней легко принять пустую фразу за важную. Дата съёма показывает, насколько данные свежие: спрос меняется, и цифры годичной давности могут уже не отражать ситуацию.
Регион проверьте отдельно: частоты и выдача должны быть сняты для того региона, где вы продаёте.
У каждой строки ядра должны быть заполнены кластер, интент и URL. Каннибализацию найти просто: отсортируйте таблицу по столбцу URL. Если один адрес повторяется у разных кластеров или один кластер ведёт на два адреса, это и есть проблема. Пустые ячейки в столбце URL тоже повод для вопроса: значит, для группы страница не назначена.
Удалённое должно быть видно: минус-слова, нулевые фразы, чужие регионы, с причиной.
Если сайт уже работает, в ядре должны быть фразы из Вебмастера и Search Console. Доступы к ним остаются на ваших аккаунтах: подрядчику выдают доступ пользователя, а владельцем остаётесь вы.
Что спросить, если пункта нет
Спросите прямо. Какой датой сняты частоты и в каком виде, базовые или в кавычках? Для какого региона снимали частоты и ТОП-10? Как группировали фразы: по выдаче или по смыслу, и сколько общих URL нужно для объединения? Где список удалённых фраз? Учтены ли запросы, по которым сайт уже показывается в Вебмастере и Search Console?
Большое число фраз само по себе не признак качества.
Когда собрать ядро самостоятельно, а когда к специалисту
Собрать семантическое ядро самостоятельно с нуля реально, если сайт небольшой, до нескольких десятков страниц, и ниша одна и понятная: услуги в одном городе, узкий ассортимент. Тогда хватит Wordstat, таблицы и терпения пройти все шесть шагов. Кластеризацию по выдаче на таком объёме можно сделать даже вручную, открывая ТОП-10 по каждой фразе.
К специалисту стоит идти, когда сайт — каталог с сотнями категорий и фильтров, когда регионов много, когда ниша конкурентная и ошибка в структуре обойдётся дорого. Ещё один повод — объём: кластеризация по выдаче на тысячах фраз требует автоматизации. И если сайт уже работает, ядро нужно сверить с данными Вебмастера и Search Console и увязать с текущими страницами.
У меня ядро — часть разового старта SEO-работ вместе с аудитом и структурой. На странице услуги эта работа описана так: «Собираем и кластеризуем ключевые запросы, распределяем спрос по текущим и новым посадочным страницам».
Гарантию позиций я не даю: позиции определяют поисковые системы. Я работаю по согласованному с клиентом ядру и фиксирую объём работ до старта.
Если хотите отдать сбор ядра вместе с продвижением, посмотрите, как устроено SEO-продвижение. Если выбираете исполнителя, пригодится статья о том, как выбрать SEO-специалиста, а из чего складывается бюджет, я разбирал в материале о стоимости SEO-продвижения.
Вопросы и ответы
Сколько фраз должно быть в ядре?
Нормы нет. Количество зависит от сайта, ниши и числа страниц.
Можно ли взять ядро конкурента?
Как источник маркеров — да. Как готовое ядро — нет: у конкурента другой регион, другие страницы и другая аудитория.
Нужно ли ядро для лендинга?
Да, небольшое. Оно поможет подобрать формулировки для текста и понять, хватит ли одной страницы или спрос просит нескольких.
Как часто обновлять семантику?
По поводам: новые услуги, другой регион, сдвиг спроса, новые запросы в Вебмастере и Search Console. Привязывать обновление к календарю необязательно.
Что делать с фразами, на которые нет страницы?
Оставить в карте релевантности как задачу: создать страницу услуги или написать статью, в зависимости от интента.
Чем ядро отличается от списка ключевых слов?
Группировкой по выдаче и привязкой каждой группы к странице.
Можно ли собрать ядро бесплатно?
Для небольшого сайта шаги можно пройти с помощью инструментов Яндекса и Google: Wordstat, Вебмастера, Search Console и Метрики, плюс обычной таблицы. Готового файла под ваш бизнес бесплатно никто не даст: ядро собирают под конкретные услуги и регион.