Claude Code для SEO: как настроить агента, чтобы он не выдумывал цифры
Агент без настройки отвечает уверенно. Спросите его про частотность запроса или позиции сайта, и он может назвать цифру, которую ниоткуда не брал. Разбираю, как настроить Claude Code для SEO через CLAUDE.md, правила и скиллы, чтобы агент указывал источник к каждой цифре и помечал непроверенное.
Я Дмитрий Паромов, 8 лет в SEO. С Claude Code работаю с момента его появления: делаю на нём аудиты по снимку краулера, ТЗ разработчику, разбор выгрузок и статьи для этого блога.
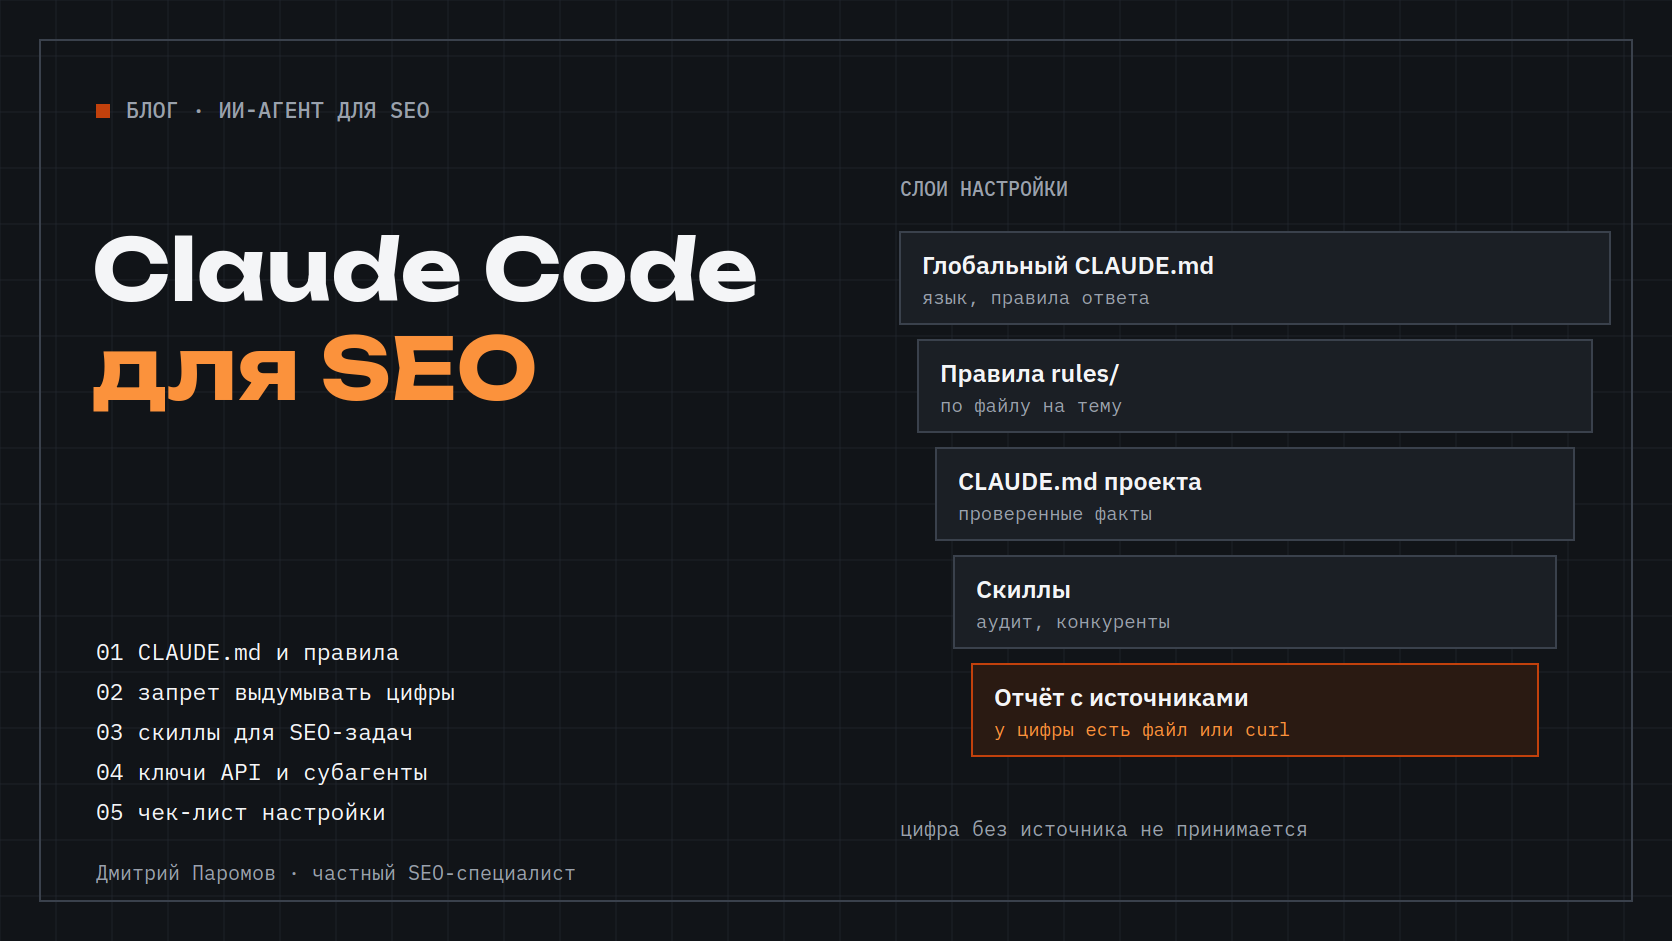
Принцип у всей настройки один: цифра без источника не принимается.
Почему SEO-специалисту нужен агент, а не чат
По официальному описанию Claude Code — агентный инструмент: он читает файлы проекта, редактирует их и выполняет команды. Документация говорит о коде, но с папкой SEO-проекта агент работает так же: открывает снимок краулера и выгрузки, проверяет URL через curl, пишет отчёт и ТЗ прямо в файлы. Чат в браузере, по моему наблюдению, работает только с тем, что вы в него вставили, а недостающее модель может достроить по памяти.
Каждая сессия при этом начинается со свежего контекста. Без настройки агент не знает ни проекта, ни формата отчётов, и пробелы может заполнить памятью модели. Отсюда короткий ответ на вопрос, как настроить ИИ-агента под SEO: дать ему постоянные правила, контекст проекта и доступ к данным.
Для старта нужны установленный Claude Code и рабочая папка с проектами. Всё остальное собирается внутри неё и в ~/.claude/.
Агент ускоряет рутину: разбор выгрузок, сверку, черновики ТЗ. Решения и проверка результата остаются за специалистом.
Из чего складывается настройка Claude Code
Настройку удобно собирать слоями: от общих правил к данным и к отчёту, где у цифр есть источник.
Верхние слои действуют во всех проектах, CLAUDE.md проекта и данные описывают конкретный сайт, а скиллы бывают и личными, и проектными. На выходе получается отчёт, где у каждой цифры указан файл, выгрузка или ответ curl.
| Где | Что хранить | Пример из SEO |
|---|---|---|
Глобальный CLAUDE.md (~/.claude/CLAUDE.md) | Кто вы, язык, правила ответа, структура проектов | «Не придумывай URL, позиции, частотности — только из реальных источников» |
~/.claude/rules/ | Отдельные темы правил, по файлу на тему | no-hallucinations.md, report-format.md, subagent-patterns.md, scripts.md |
| CLAUDE.md проекта | Проверенные факты о сайте | CMS, регион, разделы сайта, что уже проверено |
| Скилл (SKILL.md) | Многошаговая процедура | Технический аудит по снимку краулера |
| .env (в .gitignore) | Ключи API | Токены доступа к выгрузкам |
| Автопамять (MEMORY.md и файлы тем) | Решения между сессиями; пишет сам агент | «Что ждём от клиента», «как устроен сервер» |
Документация разделяет две системы памяти. CLAUDE.md пишете вы: это инструкции и правила. Auto memory пишет сам Claude: знания и закономерности, которые он заметил в работе. Обе загружаются в каждую сессию. Если запись в CLAUDE.md превратилась в многошаговую процедуру или нужна только для части проекта, документация советует перенести её в скилл или в правило с привязкой к путям.
Повторяющееся объяснение — в файл инструкций, пошаговую процедуру — в скилл.
CLAUDE.md: где лежит и что в него писать
CLAUDE.md — обычный markdown-файл с постоянными инструкциями. Claude читает его в начале каждой сессии, поэтому проект не нужно объяснять заново.
Где лежит CLAUDE.md
По документации уровней четыре, от широкого к узкому.
| Уровень | Путь | Кому доступен |
|---|---|---|
| Управляемая политика | macOS: /Library/Application Support/ClaudeCode/CLAUDE.md; Linux и WSL: /etc/claude-code/CLAUDE.md; Windows: C:\Program Files\ClaudeCode\CLAUDE.md | Все пользователи в организации |
| Пользователь | ~/.claude/CLAUDE.md | Только вы, все проекты |
| Проект | ./CLAUDE.md или ./.claude/CLAUDE.md | Команда через git |
| Локальный | ./CLAUDE.local.md (добавить в .gitignore) | Только вы, текущий проект |
Найденные файлы объединяются, а не переопределяют друг друга. Порядок загрузки — от широкой области к узкой, так что проектный файл идёт после пользовательского. CLAUDE.md из подкаталогов подгружаются по требованию, когда Claude читает или правит файлы в этой папке.
Мне для SEO хватает двух уровней: глобального и проектного.
Сколько строк и что писать
Документация советует держать каждый CLAUDE.md меньше 200 строк. Длинный файл тратит больше контекста, и инструкции соблюдаются хуже; вынос части текста в импорты стоимость не снижает. У меня норма жёстче: CLAUDE.md проекта — до 45 строк, и только проверенные факты о сайте.
Писать стоит то, что иначе пришлось бы объяснять снова: агент второй раз сделал ту же ошибку или вы из сессии в сессию повторяете одно и то же уточнение. Вот основные правила моего глобального CLAUDE.md, их можно взять за образец.
- Общайся со мной всегда на русском языке
- Технические вещи (код, команды, названия файлов, конфиги) можно писать на английском
- Будь кратким — факты и данные, без воды
- Таблицы и списки предпочтительнее длинного текста
- Если нужны данные — спроси, не выдумывай цифры
- Не придумывай URL, позиции, частотности — только из реальных источников
- К цифрам и выводам указывай источник (файл, выгрузка, curl); непроверенное помечай «предположение»
- Секреты (API-ключи) — только в .env (в .gitignore), не в CLAUDE.md и не в отчётах
Чего в CLAUDE.md быть не должно: многошаговых процедур (их место в скилле), отдельных тем правил (в rules), ключей API (в .env) и предположений о сайте, которые никто не проверял.
Почему CLAUDE.md не даёт гарантии
Документация прямо говорит: содержимое CLAUDE.md Claude получает как контекст, а не как принудительную конфигурацию. Строгого соответствия нет, особенно для расплывчатых или противоречивых инструкций. Если действие нужно заблокировать независимо от решения модели, документация предлагает hook — команду, которая срабатывает на фиксированном событии.
Проверить, что файл вообще загружен, можно командой /context: в разделе Memory files видно, какие CLAUDE.md подхватились при запуске. Нет нужного CLAUDE.md — Claude его не видит. Правила с paths грузятся по требованию, их там может не быть. Смотреть и править файлы удобно через /memory.
Правила в папке rules
Когда правил становится много, CLAUDE.md распухает. Документация предлагает выносить их в папку .claude/rules/ проекта: один файл — одна тема с понятным именем, файлы находятся рекурсивно, можно делать подпапки. Личные правила кладут в ~/.claude/rules/: они действуют во всех проектах на машине и загружаются раньше правил проекта.
Правило можно привязать к файлам через поле paths во frontmatter. Тогда оно загрузится, только когда Claude работает с совпадающими файлами.
У меня в ~/.claude/rules/ четыре файла:
- no-hallucinations.md — запрет выдумывать данные;
- report-format.md — формат SEO-отчётов;
- subagent-patterns.md — работа с субагентами;
- scripts.md — правила для скриптов, добавлен 27.10.2026.
Одна тонкость. Ни пользовательское, ни проектное правило не переопределяет другое: при конфликте Claude может выполнить любое из них. Поэтому rules и CLAUDE.md стоит время от времени сверять между собой и вычищать противоречия.
Главное правило: агент не называет цифры без источника
Галлюцинации нейросети в SEO выглядят буднично: придуманные частотности, позиции, трафик, DR и DA, URL, который на деле отдаёт 404, или старые данные под видом сегодняшних. Опасны они тем, что звучат уверенно и уходят дальше — в отчёт клиенту или в ТЗ разработчику.
Логика правила простая. Сначала прямая проверка: curl, чтение файлов, API. Если её нет — косвенная: заголовки сервера, sitemap, robots.txt, разметка. Если не вышло и так, агент пишет «Не удалось верифицировать» и называет инструмент, которым можно проверить.
Целиком файл ~/.claude/rules/no-hallucinations.md выглядит так:
Ты работаешь с SEO-данными, которые устаревают быстро. Твоя задача — приложить все усилия, чтобы верифицировать факты на сегодняшний день, используя все доступные инструменты. Врать и выдумывать — недопустимо.

ПОРЯДОК ДЕЙСТВИЙ при любом фактическом утверждении:
1. Сначала попробуй проверить: curl, Read файлов, Grep, Bash, доступные API и MCP-инструменты
2. Если прямая проверка невозможна — попробуй косвенную (заголовки сервера, sitemap, robots.txt, HTML-разметка)
3. Если проверить невозможно никак — честно напиши: «Не удалось верифицировать. Для проверки используйте [конкретный инструмент/сервис]»

ЗАПРЕЩЕНО:
- Называть частотности, позиции, трафик, DR, DA, не получив их из источника в этой сессии
- Утверждать, что URL существует, не выполнив curl -sI
- Выдавать содержимое памяти модели за актуальные данные без предупреждения
- Писать «нет данных» не попытавшись сначала их получить доступными инструментами

ОБЯЗАТЕЛЬНО:
- Каждое числовое утверждение — подкреплять источником (файл, curl-ответ, API)
- Если используешь знания из памяти модели — явно предупреждать: «Из базы знаний модели (cutoff [дата]), требует верификации»
- Текущую дату брать из системного контекста и учитывать при оценке актуальности
- Предлагать конкретный способ верификации, если сам не смог проверить
Блок ЗАПРЕЩЕНО перечисляет то, что нельзя называть без источника, полученного в текущей сессии. Блок ОБЯЗАТЕЛЬНО требует источник к каждой цифре и предупреждение, если знание взято из памяти модели.
В глобальном CLAUDE.md то же самое продублировано короче: «Если нужны данные — спроси, не выдумывай цифры», «Не придумывай URL, позиции, частотности» и требование указывать источник, а непроверенное помечать «предположение».
Как это выглядит в работе
Пример из подготовки этой статьи. Спрос на её темы агент 27.10.2026 проверил через Wordstat и в ответе указал источник, регион и тип показов. Как дальше работать с такими цифрами при сборе семантики, я разбирал в статье о том, как собрать семантическое ядро.
| Запрос | Показы, база (Wordstat, регион 225, 27.10.2026) |
|---|---|
| claude md | 881 |
| claude code skills | 722 |
| как настроить ии агента | 571 |
| claude code настройка | 262 |
| claude code seo | 62 |
У каждой цифры есть источник, дата и регион, поэтому её можно перепроверить.
При этом правило снижает риск, но не гарантирует результат. Оно остаётся таким же контекстом, как CLAUDE.md, и строгого соблюдения документация не обещает. Поэтому ответственность за цифру в отчёте по-прежнему на специалисте: агент говорит, откуда цифра, а вы открываете этот источник и сверяете.
Указан файл — откройте файл. Указан curl — повторите запрос.
Скиллы Claude Code для повторяющихся SEO-задач
Скилл (в документации — skills) — это папка с файлом SKILL.md, где лежат инструкции для одной задачи. Claude использует скилл сам, когда считает его нужным, или вы вызываете его командой /имя-скилла.
Документация советует создавать скилл, когда вы постоянно вставляете в чат одни и те же инструкции, чек-лист или многошаговую процедуру. Второй сигнал — раздел CLAUDE.md превратился в процедуру и перестал быть фактом.
Чем скилл отличается от правила
В контексте постоянно лежит только описание скилла, а тело загружается, когда скилл используют. Поэтому длинная процедура аудита почти ничего не стоит, пока она не нужна. Правила и CLAUDE.md загружаются в каждую сессию, и туда идёт то, что должно действовать всегда.
Личные скиллы лежат в ~/.claude/skills/<имя>/SKILL.md и доступны во всех проектах на этом компьютере. Проектные — в .claude/skills/<имя>/SKILL.md внутри репозитория.
По умолчанию скилл может вызвать и пользователь, и Claude. Строка disable-model-invocation: true во frontmatter оставляет только ручной вызов; документация советует так делать для действий с побочными эффектами. В SEO я бы так закрывал любой скилл, который что-то меняет во внешних системах: правит фиды, ставки или файлы на сервере. Запускать такое агент должен только по вашей команде.
Какие скиллы у меня
- Технический аудит по снимку краулера с режимами: полный, один модуль, повторный «до/после».
- Быстрый аудит произвольного сайта по URL.
- Анализ конкурентов страницы по блокам и фактам.
Вызываю их командой со слешем, либо они подключаются сами, когда задача совпадает с описанием скилла.
Где хранить ключи API
Ключи API у меня лежат только в файле .env, который внесён в .gitignore. Не в CLAUDE.md и не в отчётах: эти файлы живут в git и могут уйти клиенту или разработчику, а ключ в них увидит каждый, кто получил файл.
С субагентами то же самое. В subagent-patterns.md записано: «API-ключи не включать в промпт — субагент берёт их из ~/projects/.env так же, как основной агент».
Проверка для себя: значение ключа есть ровно в одном файле.
Как использовать Claude Code в SEO-проекте
Все мои проекты устроены одинаково, и эта структура записана прямо в глобальном CLAUDE.md.
## Структура проекта (одинаковая)
- <проект>/: CLAUDE.md, seo-plan.md, reports/audit-<дата>.md, tasks/ (ТЗ разработчику), data/
- data/snapshots/<дата>/ — снимок краулера; data/exports/{webmaster,gsc,metrika,direct}/ — выгрузки
- Порядок: снимок → аудит → интервью → план (этапы 0–5) → ТЗ. Новый краул — в новую папку с датой
- Общее: ~/projects/_shared/{templates,prompts,scripts,docs}; схема данных — ~/projects/README.md
- CLAUDE.md проекта — до 45 строк, только проверенные факты
Агенту не приходится искать данные: снимок краулера лежит в data/snapshots/<дата>/, выгрузки — в data/exports/, общее — в ~/projects/_shared/.
Порядок работы тоже зафиксирован. В обычный день это выглядит так: агент читает снимок, сверяет его с выгрузками и пишет аудит, а после интервью собирает план и ТЗ. Новый краул ложится в новую папку с датой, так что старые срезы не перезаписываются и их можно сравнить между собой.
Все проекты лежат в одном git-репозитории, а ТЗ разработчику агент пишет под CMS конкретного проекта.
Формат отчёта P1/P2/P3
Приоритет в отчёте задаётся влиянием: индексация, ранжирование, улучшение. Правило report-format.md:
Формат SEO-отчётов:

Язык: русский.

Структура файла:
1. Заголовок: «SEO-аудит [домен]», дата
2. Критичные проблемы (P1 — влияет на индексацию)
3. Важные замечания (P2 — влияет на ранжирование)
4. Рекомендации (P3 — улучшение)
5. Детальные результаты (таблицы проверок)

Таблицы: колонки «Элемент — Значение — Статус — Рекомендация».
Рекомендация — конкретное действие, не общий совет.
  Плохо: «Улучшить title»
  Хорошо: «Сократить title до 60 символов, вынести бренд в начало»

Без эмодзи. Без вводных фраз типа «Давайте рассмотрим».
«Улучшить title» нельзя ни выполнить, ни проверить. «Сократить title до 60 символов, вынести бренд в начало» разработчик сделает без уточнений, а вы проверите по факту. Как расставлять такие приоритеты, разобрано в статье про технический SEO-аудит сайта с приоритетами, а как превратить результаты в понятный клиенту документ — в материале об отчёте по SEO-продвижению.
Память между сессиями и субагенты
Автопамять
По документации Claude сам сохраняет заметки четырёх типов: user, feedback, project и reference. Лежат они в ~/.claude/projects/<project>/memory/, индекс — MEMORY.md. В начале разговора загружаются первые 200 строк или первые 25 КБ индекса, смотря что наступит раньше; это ограничение касается только MEMORY.md, на CLAUDE.md оно не распространяется. Файлы по темам Claude читает по требованию. Память своя у каждого репозитория и привязана к машине.
У меня агент записывает туда решения и договорённости между сессиями: что ждём от клиента, как устроен сервер.
Субагенты
Субагенты Claude Code нужны, когда большую задачу можно разрезать на независимые части. Главное в моём правиле для них — толстый промпт: контекст проекта, формат отчёта, ограничения верификации, входные файлы и путь для результата. Актуальная версия:
Правила работы с субагентами.

ТОЛСТЫЙ ПРОМПТ — субагент не видит историю диалога, уже вызванные скиллы и прочитанные файлы. CLAUDE.md и правила он загружает (кроме встроенных Explore и Plan), но ключевые ограничения дублируй в промпте. В промпт каждого субагента вложи:
- Релевантный контекст из CLAUDE.md текущего проекта (прочитай и передай: сайт, CMS, ниша, регион, конкуренты, ЦА)
- Формат результата из report-format.md: таблица «Элемент — Значение — Статус — Рекомендация», приоритеты P1 (индексация) / P2 (ранжирование) / P3 (улучшение), рекомендация — конкретное действие; русский язык, без эмодзи
- Ограничения верификации из no-hallucinations.md: данные только из файлов, curl и API, не из памяти модели; значения — дословные цитаты; при ошибке curl/API — сообщить код и текст ошибки, не выдумывать; не называть частотности, позиции, трафик без источника; к каждой цифре — источник
- Входные данные: конкретные URL или пути к файлам (снимок — <проект>/data/snapshots/<дата>/, выгрузки — <проект>/data/exports/)
- Путь к файлу для сохранения результата

API-ключи не включать в промпт — субагент берёт их из ~/projects/.env так же, как основной агент.

ФАЙЛ-КОНТРАКТ:
- Каждый субагент сохраняет результат в свой файл: <проект>/reports/<задача>-<дата>/<часть>.md
- После завершения всех — прочитать файлы и собрать сводку в той же папке (summary.md): общие проблемы, уникальные, топ-5 действий начиная с P1

ОГРАНИЧЕНИЯ:
- Не более 5 субагентов одновременно
- Каждому — одна независимая задача
- Не использовать для задач, где шаги зависят друг от друга
- Не использовать для простых задач, которые быстрее выполнить напрямую
- Субагентам — только чтение и запись своих файлов: никаких изменений в Директе, на серверах, в crontab, git commit/push
При подготовке этой статьи агент сверил моё правило с официальной страницей про субагентов и нашёл неточность. В первой версии правила стояло: «субагент не видит CLAUDE.md, rules, skills». По документации обычные субагенты загружают CLAUDE.md и правила проекта; без них стартуют только встроенные Explore и Plan, а также субагенты с настройкой omitClaudeMd. Не видят они историю диалога, уже вызванные скиллы и файлы, которые прочитал основной агент.
Строку я исправил 27.10.2026. Принцип толстого промпта остался: документация тоже советует обязательное для субагента правило повторить в промпте при делегировании.
По источнику проверяются и собственные правила.
Чужие правила для агента: как я адаптировал ub-mode
Пример чужого набора правил — ub-mode, скилл Роберта Мартина (Uncle Bob, автор «Чистого кода») с принципами разработки для ИИ-агента. В нём три блока: First Make it Work, Then Make it Right и Practice.
Ставить его целиком я не стал. Набор рассчитан на разработку с тестами, а в блоке про коммиты есть пункт «Push to the main line at the end», то есть отправить изменения в основную ветку в конце работы. У меня обратное правило: коммит и пуш только по моему запросу. При конфликте инструкций Claude может выполнить любую из них, так что оставить обе значит рискнуть пушем без спроса.
| Пункт ub-mode | Решение | Куда попал или почему убран |
|---|---|---|
| Идемпотентные операции | Взял, добавил dry-run перед изменениями во внешних системах | Раздел ИДЕМПОТЕНТНОСТЬ |
| Проверка данных на границе | Взял | Раздел ДАННЫЕ НА ВХОДЕ |
| Исправлять причину | Взял | Раздел ПРИЧИНА, А НЕ СИМПТОМ |
| Минимальная правка | Взял | Раздел МИНИМАЛЬНАЯ ПРАВКА |
| Работа проверяемыми шагами | Взял | Раздел ПРОВЕРКА |
| TDD | Убрал | Рассчитано на разработку с тестами |
| Утилиты crapper, dryer, mutator (сложность, дубли, мутационное тестирование) | Убрал | К SEO-скриптам не относятся |
| «Push to the main line at the end» | Убрал | Противоречит правилу «коммит и пуш только по запросу» |
Взятые идеи я переписал под свои SEO-скрипты: выгрузки, правки в рекламном кабинете, бэкапы. Получилось правило ~/.claude/rules/scripts.md от 27.10.2026:
Правила написания и правки скриптов (_shared/scripts, skills, бэкапы, cron). По мотивам github.com/unclebob/ub-mode, адаптировано.

ИДЕМПОТЕНТНОСТЬ:
- Повторный запуск или запуск после падения на середине даёт то же состояние, без дублей
- Перед записью проверить, не сделано ли уже (минус-фраза уже есть, файл уже выгружен, коммит уже есть)
- Изменения во внешних системах (Директ, Вебмастер, серверы) — сначала dry-run, применять после «да» Дмитрия

ДАННЫЕ НА ВХОДЕ:
- Ответ API/CSV/выгрузки проверять один раз при входе: код ответа, обязательные поля, типы
- При ошибке — остановиться и показать код и текст ошибки, не подставлять пустые/нулевые значения молча
- Сначала понять структуру данных, потом писать логику

ПРИЧИНА, А НЕ СИМПТОМ:
- Сначала воспроизвести ошибку, потом чинить
- try/except, который просто глушит ошибку, — не исправление

МИНИМАЛЬНАЯ ПРАВКА:
- Самое маленькое изменение, решающее задачу; сначала убрать лишнее, потом добавлять
- Одно решение — в одном месте: настройки (ID счётчиков, пути, лимиты) не дублировать по скриптам
- Новое требование не прикручивать костылём — подумать, как было бы правильно с нуля, предложить Дмитрию

ПРОВЕРКА:
- Делать по шагам, каждый шаг проверить запуском на реальных данных, потом следующий
- В конце — что изменено, зачем и чем проверено (команда, вывод)
- git commit/push — только по запросу Дмитрия
Вывод у меня такой: чужие правила для агента не копирую целиком. Читаю, ищу конфликты со своими и переношу только то, что относится к моей работе.
Ошибки при настройке агента
- Раздутый CLAUDE.md. Файл вырос за рекомендованные 200 строк, внутри пошаговые процедуры. Процедуры выносите в скиллы, темы — в rules.
- Расплывчатые формулировки. «Пиши хорошие отчёты» проверить нельзя. Конкретные инструкции, по документации, соблюдаются последовательнее; образец — строка про title из report-format.md.
- Противоречия между файлами. Глобальный CLAUDE.md говорит одно, проектный другое, правило третье, и агент может выбрать любую из этих инструкций.
- Ключи в открытых файлах: CLAUDE.md, отчёт, промпт субагента.
- Догадки в CLAUDE.md проекта. Агент будет опираться на них как на факты. У меня там только проверенное.
- Ожидание гарантии от текста правил. Для действий, которые должны выполняться в определённый момент, документация советует hook. Ответы с цифрами всё равно сверяйте по источнику.
- Чужой набор правил целиком, без сверки со своими. Пример разобран выше на ub-mode.
Чек-лист: агент готов к SEO-работе
Перед первой SEO-задачей пройдитесь по пунктам.
- Глобальный CLAUDE.md задаёт язык, правила ответа и структуру проектов.
- В
~/.claude/rules/лежит правило против выдуманных цифр. - CLAUDE.md проекта содержит только проверенные факты и укладывается в рекомендованные 200 строк.
- Формат отчёта описан отдельным правилом.
- Повторяющиеся задачи вынесены в скиллы.
- Ключи API лежат в .env, а .env внесён в .gitignore.
- У всех проектов одна структура папок, снимки и выгрузки разложены по датам.
/contextпоказывает нужные CLAUDE.md в Memory files.- Агент на контрольный вопрос о цифре называет источник или пишет «предположение».
Контрольный вопрос: спросите о частотности или позиции, данных по которой в папке нет. Настроенный агент назовёт источник, напишет «Не удалось верифицировать» или пометит ответ как предположение. Один удачный ответ не доказывает, что так будет всегда, поэтому выборочно проверяйте и дальше.
Если вам нужно SEO, где у каждой цифры в отчёте есть источник, посмотрите, как я веду SEO-продвижение.
Вопросы и ответы
Гарантирует ли правило в CLAUDE.md, что агент не выдумает цифры?
Нет. Для Claude это контекст без строгого соответствия. Помогают конкретные формулировки, проверка источника и hook для жёстких запретов.
Сколько строк должно быть в CLAUDE.md?
Документация советует меньше 200 на файл. Мой проектный CLAUDE.md — до 45 строк.
Чем скилл отличается от правила?
Правило действует в каждой сессии, а тело скилла загружается при вызове. Процедуру выносите в скилл, постоянное требование — в правило.
Можно ли взять готовые правила из интернета?
Можно, но после сверки со своими, как в истории с ub-mode.
Видит ли субагент мои правила?
По документации обычные субагенты загружают CLAUDE.md и правила проекта, встроенные Explore и Plan стартуют без них. Историю диалога, вызванные скиллы и автопамять субагент не видит, поэтому ключевые ограничения я дублирую в промпте.
Где хранить ключи API?
В .env, внесённом в .gitignore.
Нужно ли каждый раз заново объяснять проект?
Нет. CLAUDE.md и индекс автопамяти загружаются в начале сессии; у MEMORY.md — первые 200 строк или 25 КБ.