Как сэкономить токены в Claude Code через субагенты, скиллы и контекст
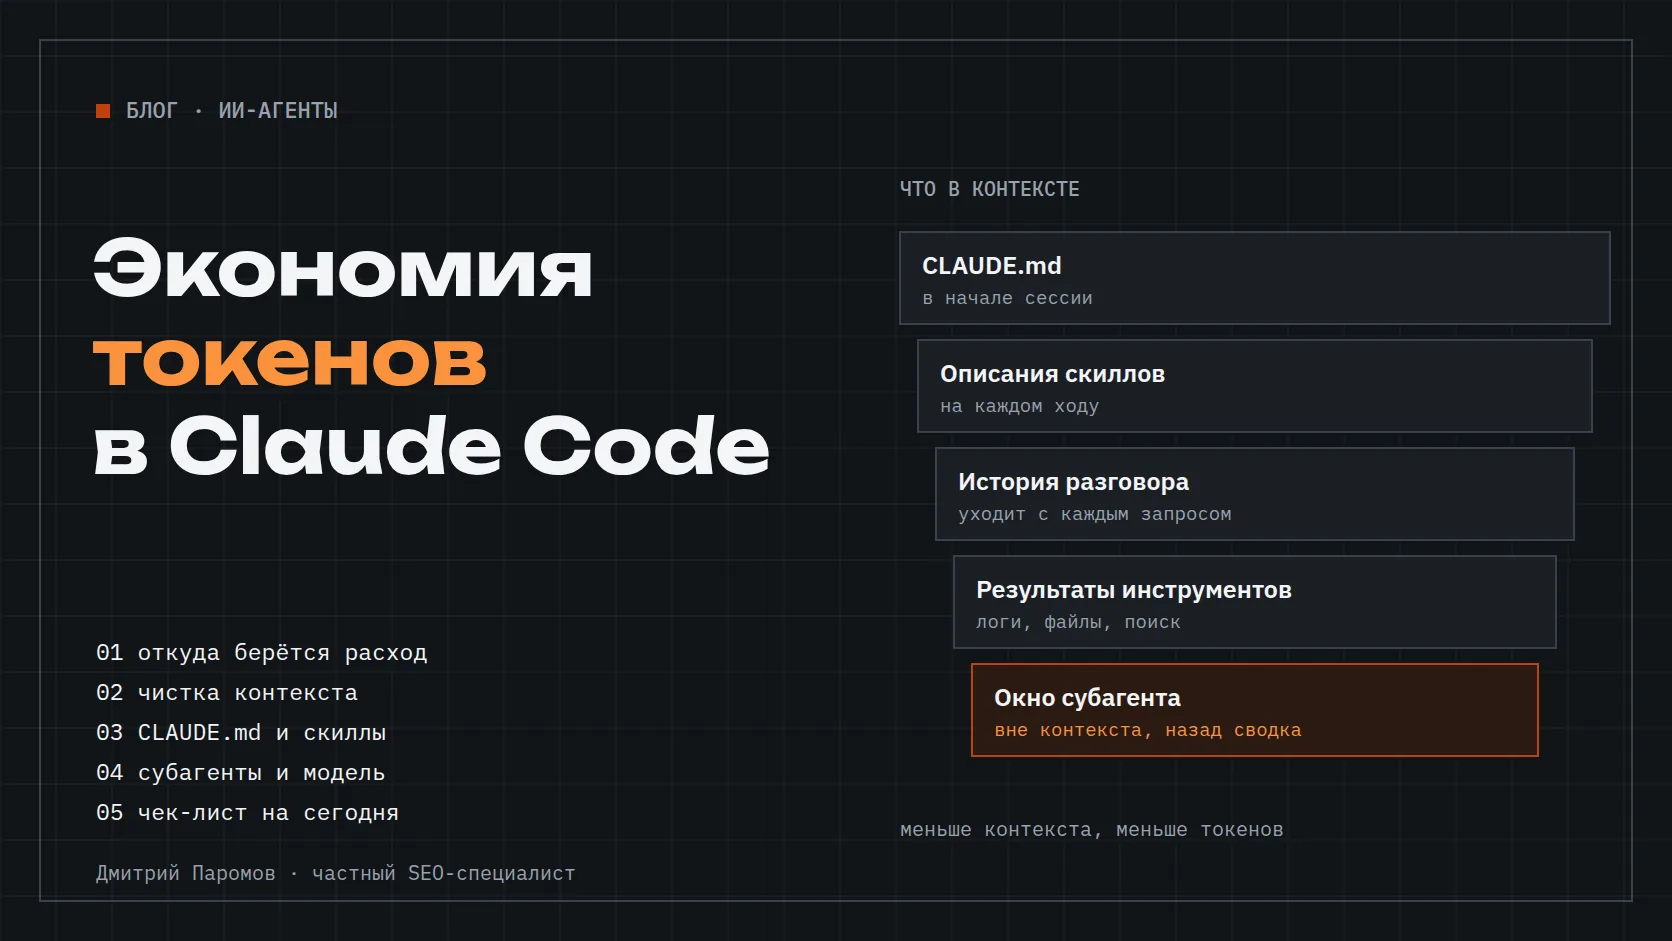
Расход токенов в Claude Code растёт вместе с размером контекста. Чем длиннее сессия и чем больше в ней постоянных инструкций, лишних серверов и объёмного вывода команд, тем быстрее кончается лимит. Поэтому экономия токенов начинается с контекста: чистка сессий, короткий CLAUDE.md, скиллы вместо длинных инструкций, осознанные субагенты, подходящая модель и effort, меньше MCP-серверов.
Я Дмитрий Паромов, веду SEO-проекты на Claude Code: аудиты, ТЗ, отчёты, статьи.
Откуда берётся расход токенов в Claude Code
Что такое токены и контекстное окно
Токен в глоссарии Claude определён как наименьшая единица текста языковой модели: слово, часть слова, символ или байт. Понятие общее для языковых моделей, включая ChatGPT.
Контекстное окно в том же глоссарии описано как объём текста, на который модель может смотреть при генерации ответа. Это её рабочая память: всё, что в неё не попало, модель в ответе не учтёт, а всё, что попало, обрабатывается и учитывается в расходе.
Почему лимиты Claude Code кончаются быстро
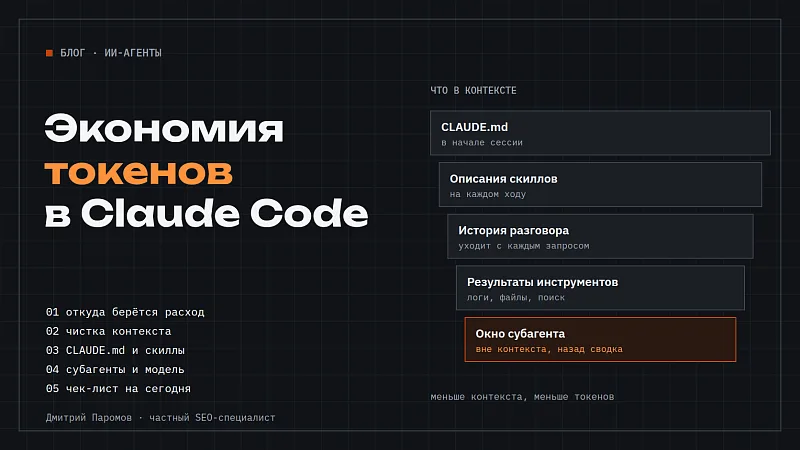
В документации по управлению расходами сказано прямо: расход токенов растёт с размером контекста. Claude Code отправляет модели всю переписку при каждом запросе, а каждый вызов инструмента даёт ещё один запрос, который уходит вместе с пачкой результатов. Прочитали десять файлов, и все десять едут дальше с каждым следующим сообщением.
Помогает кэш промпта. Повторяющееся содержимое перечитывается по кэш-тарифу, и это удешевляет длинную сессию. Но учёт он не отменяет. Документация приводит пример, который хорошо запоминается: однострочный вопрос в сессии, открытой весь день, всё равно тратит лимит на весь накопленный разговор.
У кэша есть и обратная сторона. Первое сообщение после перерыва, который длиннее времени жизни кэша, в кэш не попадает, и весь контекст обрабатывается заново. Если контекст ещё невелик, я бы сжимал его через /compact до долгого перерыва, а к несвязанной задаче после перерыва переходил через /clear. Когда контекст подходит к пределу окна, Claude Code сам сжимает историю.
Где посмотреть, что съедает место
Команда /context показывает, что занимает место в окне прямо сейчас. На тарифах Pro, Max, Ultra, Team и Enterprise команда /usage содержит раздел Attribution: недавний расход, отнесённый к скиллам, субагентам, плагинам и отдельным MCP-серверам, в процентах от общего. Цифры приблизительные, их считают по локальной истории сессий на этой машине. Но чтобы увидеть, кто тратит больше всех, этого хватает.
Если вы платите по API и счёт оказался выше ожидаемого, документация называет две типичные причины: длинные сессии, которые никогда не очищали, и Opus в роли модели по умолчанию. Обе разобраны ниже.
Какие приёмы что делают и чем рискуют
Сначала в таблице идёт то, что влияет на каждое сообщение, потом точечные приёмы. Порядок строк отражает последовательность действий и ничего не говорит о размере экономии.
| Приём | Что делает | Когда применять | Цена или риск |
|---|---|---|---|
/clear | Убирает накопленный контекст, сама очистка ничего не стоит | Между несвязанными задачами | Теряется всё, что было в разговоре, поэтому важное сохраняют в файл заранее |
/compact с инструкцией | Сжимает историю, сохраняя то, что вы указали | Когда нужна непрерывность задачи | Сам читает сжимаемый разговор, поэтому на большом контексте это крупный запрос |
| Короткий CLAUDE.md | Уменьшает постоянную часть контекста | Всегда; ориентир документации короче 200 строк | Нужно решить, что вынести в скиллы или отдельные файлы |
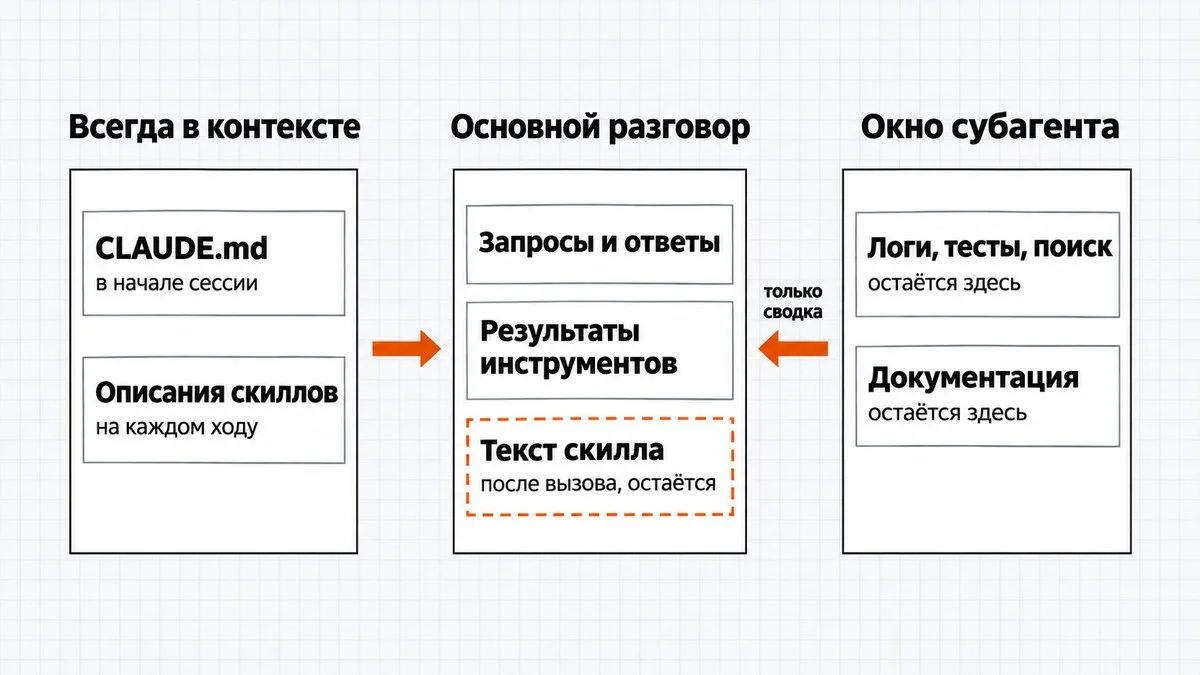
| Скиллы | Полный текст грузится только при вызове | Для редких повторяющихся процедур | Описание каждого скилла остаётся в контексте на каждом ходу |
| Субагенты | Объёмный вывод остаётся в их окне, назад приходит сводка | Тесты, логи, документация, поиск | Каждый шлёт свои запросы и тоже тратит лимит |
| Модель и effort | Sonnet стоит меньше Opus; ниже effort, меньше токенов на размышление | Для рутинных задач | Для сложных задач может не хватить глубины рассуждения |
| MCP и хуки | Отключение лишних серверов, фильтрация вывода | Когда сервер не используется или вывод огромен | Нужный сервер придётся включить снова |
Как чистить и сжимать контекст и ставить точные задачи
Очищать между задачами
Документация советует вызывать /clear между несвязанными задачами, потому что устаревший контекст тратит токены на каждом следующем сообщении. Закончили правку title-ов и переходите к разбору выгрузки? Очистите сессию. Если к старой задаче нужно будет вернуться, сначала дайте сессии имя через /rename, потом вернётесь к ней командой /resume.
Сжимать раньше предела
Когда очищать нельзя, потому что задача продолжается, используйте /compact. Ему можно передать инструкцию, что сохранить, например /compact Focus on code samples and API usage. Для SEO-проекта я бы просил оставить принятые решения и список обработанных URL.
Есть нюанс, который легко упустить. Команда /compact сама читает разговор, который сжимает, поэтому сжатие большого контекста превращается в большой запрос. Из этого я делаю вывод, что сжимать лучше раньше, пока разговор невелик, а не на пределе окна.
Формулировать задачу конкретно
Размытый запрос вроде «улучши этот код» запускает широкое сканирование. Конкретный, например «добавь проверку ввода в функцию логина в файле auth.ts», позволяет работать с минимумом прочитанных файлов. Для SEO идея переносится без изменений. «Проверь сайт» заставит агента лезть куда попало. «Проверь title и description у страниц из файла urls.txt и выведи те, где длина больше 60 и 160 символов» оставит в контексте только нужное.
Для сложных задач документация рекомендует режим планирования (Shift+Tab): он помогает не переделывать дорогую работу, если направление выбрано неверно. А если агент пошёл не туда, остановите ход клавишей Escape. Команда /rewind или двойной Escape вернёт разговор и код к чекпоинту.
Не пускать тяжёлый вывод в диалог
Это мой опыт, не документация. Выгрузки из SERP, Wordstat и краулы я кэширую на диск и разбираю скриптами. В диалог попадает только итог работы скрипта, а не сотни строк сырых данных.
CLAUDE.md и скиллы Claude Code, что грузится всегда и что по требованию
CLAUDE.md присутствует в каждой сессии
Файл CLAUDE.md загружается в контекст в начале сессии. Значит, каждая его строка стоит токенов, даже если сегодня вы делаете задачу, к которой она не относится. Подробные инструкции под отдельные процессы остаются в контексте и при несвязанной работе. Документация предлагает держать файл короче 200 строк и оставлять только самое необходимое.
Что даёт скилл вместо CLAUDE.md
Скилл грузится иначе. В обычной сессии в контексте находятся только описания всех скиллов, а полное содержимое подгружается, когда скилл вызывают. Поэтому специальные инструкции под отдельный процесс выгоднее переносить из CLAUDE.md в скилл: базовый контекст уменьшается.
Бесплатными скиллы при этом не становятся. Каждый скилл в списке добавляет контекст на каждом ходу, используют его или нет, а описание вместе с полем when_to_use обрезается на 1 536 символах. После вызова текст SKILL.md входит в разговор одним сообщением и остаётся там на следующих ходах. Документация советует держать SKILL.md короче 500 строк, а детали выносить в отдельные файлы.
Решение получается такое. Что нужно в каждой сессии проекта, пишите в CLAUDE.md: структуру папок, язык отчётов, запреты. Что нужно изредка, но по длинному сценарию, делайте скиллом. Лишние скиллы, которыми не пользуетесь, лучше удалить: их описания всё равно приходят в контекст.
Как это устроено у меня
Я держу жёсткий лимит строк: обещание писать коротко мне кажется менее надёжным. Мои размеры на 15.11.2026 по замеру wc:
- глобальный CLAUDE.md: 35 строк, 2 935 байт;
- проектные CLAUDE.md: 22, 36 и 43 строки при моём лимите 45 строк;
- четыре файла правил в
~/.claude/rules/: по 17–25 строк, около 8,5 КБ вместе; - пять собственных скиллов: аудит сайта, анализ релевантности, анализ конкурентов, Директ и SEO-аудит по снимку краулера;
- MEMORY.md устроен как индекс: одна строка на запись, около 29 записей, 5,9 КБ.
13.11.2026 я сократил проектный CLAUDE.md до действующих фактов, а подробности вынес в notes.md с пометкой «читать по теме». Подгрузка notes.md только по теме — мой способ организации файлов. Размеры выше даны в байтах и строках, в токенах я их не считал.
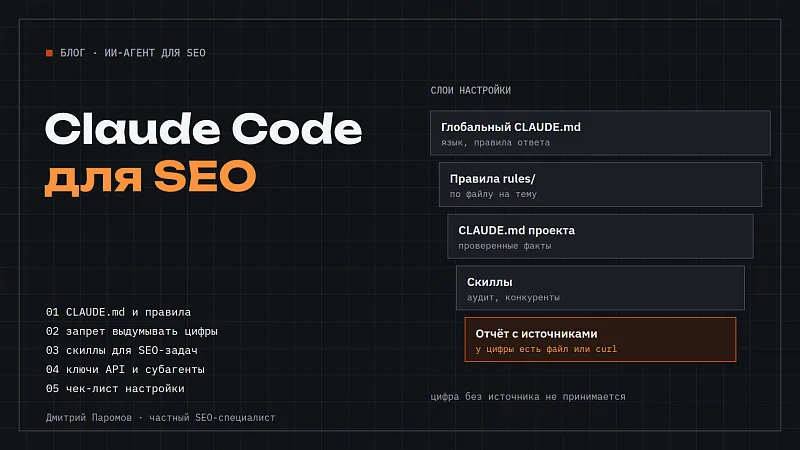
Как настроить такие файлы под SEO, я описывал в статье про Claude Code для SEO: там же правила для CLAUDE.md и примеры скиллов.
Когда субагенты Claude Code экономят токены, а когда тратят больше
Что субагент делает с контекстом
Субагент работает в собственном окне контекста со своим системным промптом, доступом к инструментам и правами. Документация советует использовать его, когда побочная задача завалит основной разговор результатами поиска, логами или содержимым файлов, которые больше не понадобятся. Вся работа идёт в окне субагента, обратно приходит только сводка.
Поэтому субагент помогает там, где вывода много: тесты, получение документации, обработка логов. Документация прямо советует делегировать такие задачи, чтобы подробный вывод остался в его окне.
Когда субагент добавляет расход
Запросы субагента расходуют ваш лимит. Каждый субагент шлёт собственные запросы поверх основного разговора, поэтому на коротких задачах выигрыш может быть небольшим, а расход растёт. Цифр для обычных субагентов в документации нет.
Отдельно предупреждение про агентные команды (agent teams). По документации они расходуют примерно в 7 раз больше токенов, чем обычные сессии, когда участники работают в режиме плана: у каждого свой контекст и отдельный экземпляр Claude. Эта цифра относится именно к командам в режиме плана и не оценивает обычного субагента. Задачи команде документация советует делать небольшими и самостоятельными.
Модель субагента
По умолчанию определённый вами субагент работает на той же модели, что и разговор, который его запустил. Для простых задач в настройках субагента можно указать model: haiku, это дешевле. Учтите наследование: если вы переключились на Opus, он применяется и к субагентам, которые наследуют модель сессии.
Мои правила для субагентов
Это мой опыт. Субагент не видит истории диалога, поэтому всё нужное я вкладываю в задание: контекст проекта, формат результата, входные файлы и путь, куда сохранить итог. Ключи API в задание не попадают, они лежат в .env.
- Результат каждого субагента идёт в свой файл, а сводку я собираю отдельным шагом. В основной диалог возвращаются файлы, а не полный вывод.
- Одновременно не больше пяти, и у каждого одна независимая задача.
- Для простых задач и для задач с зависимыми шагами субагентов не запускаю: проще сделать самому.
- Субагентам только чтение и запись собственных файлов, без изменений в рекламных кабинетах, на серверах и в crontab.
Порог такой: субагент оправдан, если его вывод объёмный и в основном разговоре не понадобится. Если ответ умещается в несколько строк, задачу лучше решить в основном окне.
Выбор модели и effort
Документация по управлению расходами говорит, что Sonnet справляется с большинством задач программирования и стоит меньше Opus. Opus стоит оставлять для сложных архитектурных решений и многошагового рассуждения. Переключать модель можно прямо в сессии командой /model. Для SEO-задач, где в основном работа с таблицами и текстом, рутину разумно вести на Sonnet, а более сильную модель оставить для разбора сложной структуры данных.
Второй рычаг связан с расширенным мышлением. Оно включено по умолчанию, токены размышления тарифицируются как выходные, а бюджет по умолчанию в зависимости от модели может составлять десятки тысяч токенов на запрос. Снизить расход можно, уменьшив уровень effort через /effort или в /model, либо отключив мышление в /config. Отключить его получится не на всех моделях: на Sonnet 5.5, Opus 5.5, Haiku 5.5 и Fable расширенное мышление работает всегда, и там снизить расход можно уровнем effort.
Уместно это там, где задача простая: переименовать файлы, привести таблицу к формату, сверить список. Для сложного разбора я бы уровень не снижал, потому что рассуждение может ухудшиться. Насколько, зависит от задачи.
MCP и хуки в Claude Code
Определения MCP-инструментов по умолчанию отложены. В контекст попадают только имена инструментов и инструкции серверов, пока Claude не начнёт использовать конкретный инструмент. Значит, подключённый сервер не бесплатен: даже неиспользуемый, он оставляет в контексте имена и инструкции. Что именно занимает место, покажет /context, а серверы, которые вам не нужны, отключите через /mcp.
Если у сервиса есть консольная утилита, выбирайте её. По документации инструменты вроде gh, aws, gcloud и sentry-cli эффективнее по контексту, чем MCP-серверы, потому что не добавляют листинг по каждому инструменту.
Хуки пригодятся для объёмного вывода. Документация приводит пример: вместо чтения лога на 10 000 строк хук может отфильтровать его по ERROR и вернуть только совпавшие строки, а это сокращает контекст с десятков тысяч токенов до сотен. Это пример из документации. Идея работает и в SEO: краул на тысячи URL лучше сначала отфильтровать по кодам ответа, а уже потом показывать агенту.
Как это выглядит в SEO-проектах
В SEO больше всего вывода дают краулы и выгрузки. Поэтому из всех приёмов выше мне нужнее всего два: фильтровать такой вывод хуком и сохранять выгрузки на диск, а не вставлять в диалог.
Если вы хотите настроить агента под SEO с нуля, начните со статьи про Claude Code для SEO. А если вам интересно, как нейросети влияют на выдачу, у меня есть разбор того, как попасть в Яндекс Нейро. Если настраивать инструменты некогда и нужен результат, посмотрите, как я веду SEO-продвижение.
Что сделать сегодня
- Откройте
/contextи/usageи посмотрите, что занимает место и на что приходится расход. - Очищайте сессию командой
/clearмежду несвязанными задачами, а/compactвызывайте с инструкцией и до того, как контекст раздулся. - Сократите CLAUDE.md до необходимого и вынесите редкие процедуры в скиллы.
- Удалите скиллы, которыми не пользуетесь, и отключите неиспользуемые MCP-серверы через
/mcp. - Для простых субагентов укажите
model: haiku, а рутину по возможности ведите на Sonnet. - Тяжёлые выгрузки читайте скриптами, а в диалог отдавайте только итог.
- Формулируйте задачи конкретно: какая функция, какой файл, какой результат.
Вопросы и ответы
Как посмотреть, на что уходят токены?
Команда /context показывает, что занимает место в окне, а на тарифах Pro, Max, Ultra, Team и Enterprise раздел Attribution в /usage разбивает недавний расход по скиллам, субагентам, плагинам и MCP-серверам.
Что такое токены простыми словами?
Это кусочки текста, на которые модель его делит: слово, часть слова, символ или байт. Расход и размер контекстного окна считаются в токенах, а не в словах.
Чем скилл отличается от CLAUDE.md?
CLAUDE.md загружается в контекст в начале сессии целиком. У скилла в контексте только описание, а полный текст подгружается при вызове.
Насколько дороже субагенты?
Точной цифры для обычных субагентов нет. Известно, что каждый шлёт свои запросы поверх основного разговора. Цифра 7 в документации относится к агентным командам в режиме плана.
Помогает ли очистка контекста?
По документации, устаревший контекст тратит токены на каждом следующем сообщении, а /clear ничего не стоит. Для связанной задачи вместо очистки используйте /compact с инструкцией.
Нужно ли отключать расширенное мышление?
Необязательно. Для простых задач можно снизить effort. Мышление в /config отключается не на всех моделях: на Sonnet 5.5, Opus 5.5, Haiku 5.5 и Fable оно всегда включено, и там остаётся effort. Для сложных задач рассуждение полезнее оставить.
Почему счёт на API неожиданно высокий?
Документация называет две частые причины: долгие сессии без очистки и Opus, оставленный моделью по умолчанию.